직관적으로 이해하기
클리핑과 마스킹을 API만 다른 동일한 동작, 즉 둘 다 "이 콘텐츠에서 원치 않는 부분을 잘라낸다"라고 취급하고 싶은 유혹이 있다. 단순한 경우에는 그 결과가 맞지만, 경계가 단순한 직선보다 조금이라도 흥미로워지는 순간 그 사고 모델은 틀린 것이 된다.
- 클립은 예/아니오 테스트다: 어떤 draw 호출이 건드리려는 모든 픽셀에 대해, 클립 스택은 "이 점이 도형 내부에 있는가"를 묻고, 그 답은 이항적이다. 60%만 클리핑된 픽셀 같은 건 존재하지 않는다.
- 마스크는 알파 곱셈이다: 이미 렌더링된 결과를 가져와서 그 알파값을 두 번째 이미지의 알파값으로 픽셀 단위로 스케일링한다. 그 두 번째 이미지는 0에서 1 사이의 어떤 알파값이든, 그레이디언트든, 블러든, 사진 자체의 휘도든 가질 수 있다. "도형이냐 아니냐"에 국한되지 않는다.
- 클리핑은 draw 호출이 무엇을 그리기 전에 어디에 쓸 수 있는지에 대한 제약으로 해석된다. 마스킹은 이미 완전히 그려진 콘텐츠에 대한 블렌드로서 해석된다.
이 두 메커니즘은 단 한 가지 특수한 경우에만 동일한 픽셀을 만들어낸다: 경계가 뚜렷한 불투명 도형. 바로 그 겹치는 부분 때문에 둘을 서로 바꿔 써도 되는 것처럼 취급되다가, 부드러운 경계가 필요한 순간 둘 중 하나가 구조적으로 그걸 제공할 수 없다는 사실을 발견하게 된다.
- →BlendMode vs CompositingStrategy: It's Not a Fence, It's a Different CanvasDstIn, SrcIn, and the Offscreen layer this post's masking technique builds on, explained from the blend-formula side.
- →Modifier Order Matters: It's a Wrapper Chain, Not a Property BagWhy clip() has to sit on the outside of background() or border() to actually cut them, the wrapper-chain reasoning this post's clip stack relies on.
구체적인 예: 사진 가장자리를 페이드하기
"이걸 어떤 모양으로 잘라내라"는 요구에는 당연히 clipPath가 먼저 떠오른다:
// Canvas clip stack: clipPath pushes a binary stencil onto the canvas.
// Every pixel inside the path is fully visible, every pixel outside it
// is fully gone. There is no third option, so the bottom edge of the
// photo just stops, hard, at whatever line you draw.
Canvas(Modifier.size(240.dp)) {
    val fadeLine = size.height * 0.7f
    clipRect(bottom = fadeLine) {
        drawImage(photo, dstSize = IntSize(size.width.toInt(), size.height.toInt()))
    }
}fadeLine을 점점 줄여도 페이드가 생기지 않고, 더 작은 위치에서 생기는 또 다른 하드 컷오프만 생길 뿐이다. 클립 경계는 그것이 그려지는 바로 그 한 경계선에서는 될 수 있지만, 그 경계선 앞 40px 구간을 점점 투명하게 만들 수는 없다. "점점 투명해짐"이라는 것 자체가 클립 스택의 개념에 전혀 존재하지 않기 때문이다. 마스킹은 그렇지 않다:
// Layer + mask: draw the photo into its own layer, then composite a
// gradient on top with DstIn. DstIn keeps dst (the photo, already
// rendered) scaled by src's alpha (the gradient), and the gradient's
// alpha runs continuously from 1 to 0, so the photo fades instead of
// cutting off.
Box(
    Modifier
        .size(240.dp)
        .graphicsLayer { compositingStrategy = CompositingStrategy.Offscreen }
        .drawWithContent {
            drawContent()
            drawRect(
                brush = Brush.verticalGradient(
                    0.6f to Color.Black,
                    1f to Color.Transparent,
                ),
                blendMode = BlendMode.DstIn,
            )
        },
) {
    Image(photo, contentDescription = null, modifier = Modifier.fillMaxSize())
}
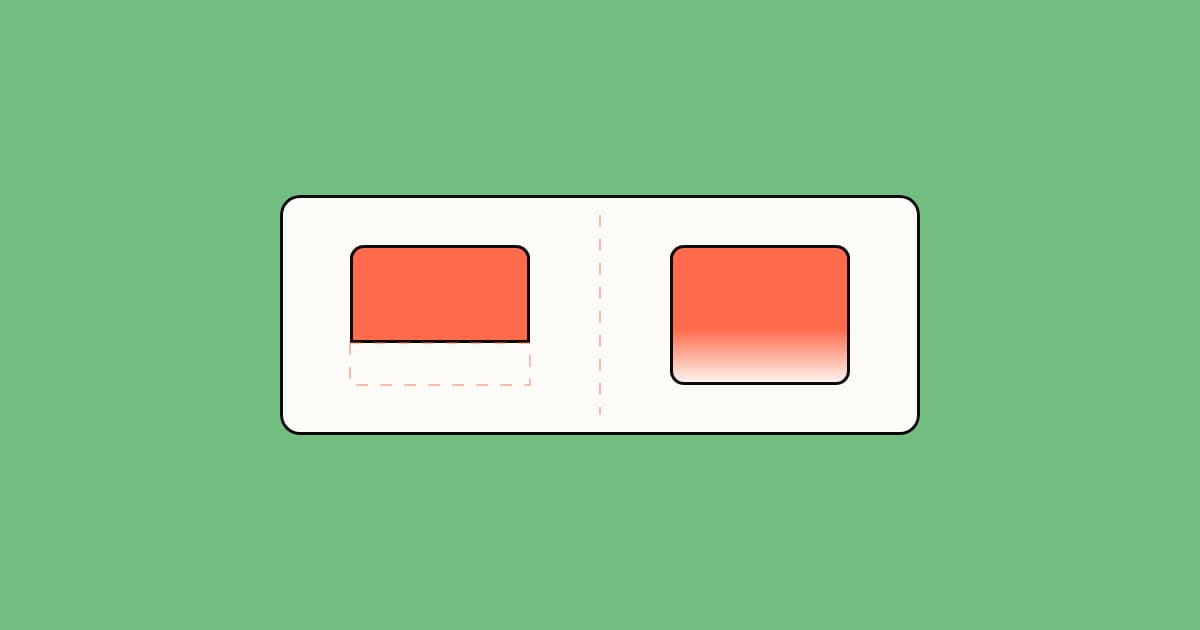
시각적 목표는 동일하다, 즉 사진의 아래쪽을 잘라내는 것인데, 마스크 버전은 클립 버전이 구조적으로 표현할 수 없는 것, 즉 부분적으로만 보이는 영역을 표현할 수 있다.
Drag the line. Everything past it is just gone, no partial values. Clip mode: the boundary is a hard yes or no test, nothing past the line is visible, with no gradual fade.
핵심 원리
클리핑은 draw 호출이 어디에 쓸 수 있는지를 제한한다: 기하학적 경계에 대한 이항적인 내부/외부 테스트이며, 어떤 페인팅이 일어나기 전에 해석된다.
마스킹은 알파 합성 단계다. 보통 BlendMode.DstIn/SrcIn을 이미 렌더링된 레이어에 적용하여 기존 픽셀을 두 번째 이미지의 알파 채널로 곱한다. 마스크의 알파값은 연속적으로 변할 수 있지만, 클립의 답은 언제나 예 또는 아니오뿐이다.
Modifier.clip(shape)은 이항적인 경우를 위한 내장 단축 수단이다. clipPath를 직접 다루는 수고를 덜어주지만, 여전히 클립이다: 부드러운 경계를 요청해도 물어볼 것이 없다, 그 도형에는 농도를 조절할 알파 채널 자체가 없기 때문이다.
같은 비대칭성이 각각이 입력으로 받는 것에서도 드러난다. 클립의 경계는 항상 Path(또는 그것으로 컴파일되는 Shape의 외곽선)다; 기하학적 내부/외부 테스트를 설명할 다른 방법이 없기 때문이다.
마스크의 소스는 그럴 필요가 없다. 그저 그 레이어에 렌더링된 무엇이든 될 수 있다: 그레이디언트로 채워진 사각형, 블러 처리된 원, 사진 자체의 픽셀. Path는 거기에 그릴 수 있었던 수많은 것들 중 하나일 뿐이다.
다른 곳에서는: 같은 원리, 다른 프레임워크
- CSS:
clip-path는 이항적인 내부/외부를 가르는 단단한 기하학적 경계이지만,mask-image는 그레이디언트나 부분 알파를 가진 PNG를 받아들여 그에 따라 페이드한다, 왜냐하면 이것은 도형 소속 여부를 테스트하는 것이 아니라 알파값을 읽는 것이기 때문이다. - SVG:
<clipPath>는 자식 도형들을 합쳐 하나의 이항적인 내부/외부 테스트로 만든다.<mask>는 설계상 명시적으로 단계적이다: 마스크 콘텐츠의 흰색 픽셀은 완전히 보임을, 검은색은 완전히 숨김을, 회색은 부분적으로 보임을 의미하며, 이는<clipPath>가 표현할 방법이 없는 연속체다. - CoreAnimation (iOS):
cornerRadius와 함께 쓰인layer.masksToBounds는 레이어 자신의 기하학적 경계에 클리핑한다, 이항적이고 도형만으로 결정된다. 대신layer.mask를CAGradientLayer로 설정하면 진짜 알파 페이드가 만들어진다, 왜냐하면mask는 경계를 테스트하는 대신 마스크 레이어의 알파 채널을 읽기 때문이다. - SwiftUI:
.clipShape(RoundedRectangle(cornerRadius: 16))은 다른 곳과 마찬가지로 이항적인 기하학적 컷이다..mask(LinearGradient(colors: [.black, .clear], startPoint: .top, endPoint: .bottom))은 대신 그레이디언트 뷰의 알파를 읽는다, 스크롤 뷰 가장자리를 페이드할 때 쓰이는 SwiftUI의 표준적인 트릭이며, 위 Compose 예제와 동일한 DstIn 방식의 메커니즘이고, 그저 뷰 모디파이어로 표현된 것일 뿐이다. - Flutter:
ClipRRect/ClipPath/ClipOval은 자식을 그리기 전에 캔버스에 이항적인 클립을 적용한다.ShaderMask는 대신Shader(예:LinearGradient)를BlendMode를 통해 이미 그려진 자식 위에 알파 마스크로 적용한다, 동일한 DstIn 방식의 연속적인 페이드다.
사용 사례: 실제로 무엇을 선택해야 하는가
- 둥근 아바타나 썸네일: 클립. 경계는 페이드할 것이 전혀 없는 고정된 기하학적 도형이며, 클립이 만들어진 바로 그 이항적인 경우에 정확히 들어맞는다.
Modifier.clip(CircleShape). - 스크롤 가능한 리스트의 위/아래 가장자리를 페이드하여 행이 중간에서 잘린 것처럼 보이지 않게 하기: 마스크. 가장자리는 몇 픽셀의 구간을 거쳐 완전히 불투명에서 완전히 투명으로 바뀌어야 하며, 이는 경계 테스트가 아니라 오직 연속적인 알파 그레이디언트만이 표현할 수 있다.
- 사진에 파낸 듯이 보이는 텍스트(텍스트 모양으로 구멍이 난 느낌):
BlendMode.DstOut을 통한 마스크. 왜냐하면 draw 호출이 어디에 놓일 수 있는지를 제한하는 것이 아니라, 다른 도형의 알파값을 기준으로 이미 그려진 레이어의 일부를 지우는 것이기 때문이다. - 사진을 고정된 종횡비 프레임에 맞춰 크롭하기: 클립. 프레임의 경계는 고정된 기하학적 경계이며, 페이드할 것이 전혀 없다, 그 바깥의 픽셀은 그냥 존재하지 않아야 한다.
- 사진 테두리 주변의 부드러운 비네트: 라디얼 그레이디언트를 알파 소스로 쓰는 마스크, 위 페이드 예제와 동일한 DstIn 메커니즘이지만 선형이 아니라 방사형일 뿐이다.
엣지 케이스
-
자신의 그림자를 클리핑으로 잘라내는 경우.
clip()은 "흘러넘쳐야 하는 콘텐츠"에 대한 예외를 두지 않는다. 그 안에 중첩된 모든 draw 호출에 동일한 이항적 내부/외부 테스트를 적용하며, 이는shadow()자체의 블러에도 마찬가지다. 그래서 클립 안에 중첩된 그림자는 원래 그 경계를 넘어 흘러나가야 했는데도 바로 그 경계에서 조용히 잘려나간다:// clip is outside shadow here, so shadow is nested inside the clip // scope. The clip stack doesn't know "that draw call was a shadow," // it just sees a draw call outside its geometric bounds and discards it. Modifier .clip(RoundedCornerShape(16.dp)) .shadow(8.dp, RoundedCornerShape(16.dp))이것은
DstIn으로 고칠 마스킹 문제가 아니라, 클립이 무조건적이라는 사실을 보여주는 사례다: 그 경계에 짓눌리지 않길 원하는 것은 더 큰 반경을 준다고 되는 게 아니라, 클리핑된 범위 바깥에서 완전히 따로 그려야 한다. -
중첩된 클립은 서로 한다, 덮어쓰지 않는다. 중첩된 두 개의
clipRect(또는clipPath) 범위는 안쪽 범위가 바깥쪽 범위의 경계를 대체하도록 허용하지 않는다, 클립 스택은 둘을 AND 연산으로 합친다:// Outer clip keeps only the left 80% of the canvas. Inner clip asks // for the right 80%. They overlap in the middle 60%, and that's all // that's actually visible, even though the inner clip's own bounds // reach further right than the outer clip allows. clipRect(right = size.width * 0.8f) { clipRect(left = size.width * 0.2f) { drawImage(photo, dstSize = IntSize(size.width.toInt(), size.height.toInt())) } }가장 안쪽 클립이 최종적으로 보이는 영역을 단독으로 결정하리라 예상했다면, 바로 여기서 뜻밖의 결과를 보게 된다: 보이는 영역은 언제나 현재 스택에 올라와 있는 모든 클립의 교집합이며, 결코 가장 최근에 적용된 클립만으로 결정되지 않는다.
실제로 써야 할 사고 모델
클립은 예/아니오 질문(이 점이 도형 내부에 있는가)에 답하고, 마스크는 얼마나(how much) 질문(이 픽셀의 알파값을 저것으로 곱하라)에 답한다. 경계가 정말로 단단한 기하학적 직선일 때는 클립을 쓰고, 그 경계의 일부라도 완전히 안이거나 완전히 밖인 것 이상이 되어야 하는 순간에는 마스크를 써라.