코루틴이 실제로 무엇인지
코루틴은 중간에 멈췄다가 나중에 다시 이어서 실행할 수 있는 작업 단위로, 그
과정에서 자신이 실행되고 있는 스레드를 블로킹하지 않는다. 멈출 수 있는
함수는 suspend로 표시한다.
suspend 함수를 호출하는 것은 일반적인 함수 호출처럼 처음부터 끝까지
한 번에 실행되지 않는다. 아직 할 일이 없는 지점(IO를 기다리거나,
delay()를 기다리거나, 다른 코루틴을 기다리는 지점)에 도달하면
Dispatcher에게 제어권을 돌려준다. 결과가 준비되면 바로 그 지점부터 다시
실행을 이어간다.
직관
launch { }과 async { }은 마치 "백그라운드 작업을 띄우고 넘어간다"처럼
읽힌다. 대부분의 튜토리얼이 심어주는 그림이 바로 이것이고, 이는 특정한
방식으로 틀렸다: 코루틴을 마치 스레드를 하나 띄우고 그 존재를 잊어버리는
것과 똑같이, 어디에도 매이지 않고 떠다니는 것처럼 취급한다는 점이다.
- 모든 코루틴은
CoroutineScope안에서 시작하며, 이 Scope가 코루틴이 얼마나 오래 살 수 있는지에 대한 경계가 된다. - 모든 코루틴은
Job을 가지고 있는데, 이는 코루틴의 상태와 부모-자식 코루틴으로 이루어진 트리 안에서의 위치를 추적하는 객체다. - 부모를 취소하면 그 트리에 속한 모든 자손도 함께 취소된다. 특별히 만들어진 재귀적 취소 루프 때문이 아니라, 트리라는 구조 자체가 그런 것이기 때문이다.
launch/async를 "작업을 하나 띄운다"보다는 "이 트리에 가지를 하나
추가한다"로 생각해보자. 따로따로 외워야 했던 긴 규칙 목록—왜 취소가
전파되는지, 왜 한 자식의 크래시가 형제들까지 끌고 내려가는지, 왜
GlobalScope가 위험한지—이 하나의 그림, 즉 트리로 압축된다.
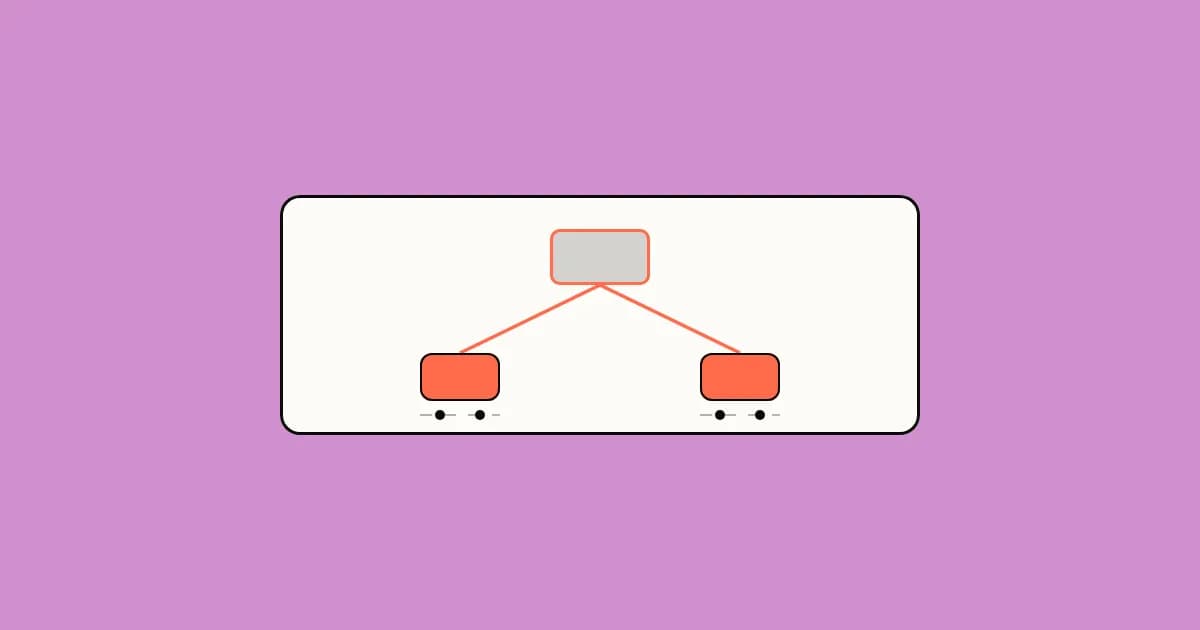
여기 있는 모든 박스는 하나의 Job이다. launch와 async는 Job을
추가하는 두 가지 다른 방법일 뿐이며, 실질적인 차이는 하나다: launch는
그 가지 자체에 대한 핸들만 돌려주고, async는 그 가지가 나중에 내놓을
결과까지 담고 있는 Deferred를 돌려준다. Root를 취소하면 A, A1,
B, B1이 모두 함께 취소되는데, 이들이 따로따로 찾아내야 하는 별개의
존재가 아니라 그저 이 트리에서 그 아래에 있는 부분이기 때문이다.
중단이 실제로 동작하는 방식: 상태 머신
코틀린 컴파일러에는 함수를 호출 중간에 멈추게 하는 별도의 런타임 마법이
없다. 컴파일러는 suspend 함수를 상태 머신으로 다시 작성한다. 각 중단
지점은 번호가 매겨진 상태가 되고, 함수의 로컬 변수들은
다시 시작할 위치를 기억하는
으로 옮겨진다.
suspend fun loadUser(id: String): User {
    val token = fetchToken()          // state 0, suspends here
    val profile = fetchProfile(token) // state 1, suspends here
    return profile.toUser()           // state 2, returns
}loadUser를 호출해도 fetchToken을 기다리며 블로킹되는 것은 없다. 이
호출은 Continuation을 돌려주고 제어권을 Dispatcher에게 넘긴다. 토큰이
도착하면 Dispatcher가 그 Continuation을 호출하여, loadUser는 state
1에서 다시 시작되고 token은 저장해두었던 값 그대로 복원되어 있다.
이것이 또한 취소가 즉각적이지 않고 협력적인 이유다(자세한 내용은 아래에서 다룬다): 코루틴은 오직 중단 지점에서만 중단시킬 수 있는데, 상태 머신이 무언가를 확인할 수 있는 스케줄러에게 제어권을 돌려주는 순간이 바로 그때뿐이기 때문이다.
콜백 기반 API를 트리에 연결하기: suspendCancellableCoroutine
모든 중단 지점이 다른 suspend 함수를 호출하는 데서 생기는 것은 아니다. 안드로이드에는 값을 반환하는 대신 콜백을 호출하는 것으로 끝나는 콜백 기반 API(ActivityResultCaller, 리스너 형태의 SDK 등)가 가득한데, 이들은 코루틴에 대해 아무것도 모른다. suspendCancellableCoroutine은 그런 API 중 하나를, 트리가 볼 수 없는 옆길이 아니라 진짜 중단 지점으로 바꾸는 방법이다.
suspend fun awaitLocation(): Location = suspendCancellableCoroutine { continuation ->
    val listener = LocationListener { location -> continuation.resume(location) }
    locationProvider.requestLocation(listener)

    continuation.invokeOnCancellation {
        locationProvider.removeListener(listener)
    }
}
위의 상태 머신이 컴파일러에 의해 생성되고 연결된 Continuation을 받는 것과 달리, suspendCancellableCoroutine은 그 Continuation을 직접 넘겨준다. 람다 안에서 그것을 붙잡아 두고, 콜백 기반 API를 시작시킨 다음, 실제 콜백이 결과와 함께 발생했을 때 수동으로 다시 시작한다.
invokeOnCancellation은 이것을 실제로 트리에 묶어주는 부분이다. awaitLocation()을 호출한 scope가, 위치 요청이 아직 대기 중인 상태에서 취소된다고 해보자. locationProvider는 그 사실을 전혀 모르기 때문에, 누군가 멈추라고 말할 때까지 listener를 계속 호출한다. invokeOnCancellation이 없다면 이 listener는 자신을 만든 코루틴이 더 이상 존재하지 않는 시점을 지나서도 계속 살아남는데, 이는 이 글 뒤에서 다룰 GlobalScope 누수와 같은 형태의 누수다. 취소 핸들러는 부모가 취소되는 바로 그 순간 실행되어, listener가 다시 발생하기 전에 그것을 제거한다.
바로 이 점이 콜백 기반 API를 트리로 들어오는 옆문이 아니라 평범한 노드처럼 느껴지게 만든다: 취소는 부모로부터 그 안으로 닿을 수 있으며, 이는 컴파일러가 생성한 어떤 중단 지점에 닿는 것과 마찬가지다.
Dispatcher: 왜 하나의 스레드가 여러 코루틴을 실행하는가
Job은 한 코루틴이 다른 코루틴들과 어떤 관계를 맺고 있는지를 나타낸다.
CoroutineDispatcher는 실제로 그 코루틴을 실행하는 스레드, 혹은 스레드
풀이 무엇인지를 나타낸다. 이 둘은 서로 다른 질문이며, 이 둘을 뒤섞어
생각하는 지점에서 "스레드는 한 번에 한 가지 일만 할 수 있다"는 직관이
사람들을 잘못된 길로 이끈다.
- 중단된 코루틴은 스레드를 전혀 점유하지 않는다. 그저 힙 위에 놓여 다시 시작되기를 기다리는 Continuation일 뿐이다.
- Dispatcher는 코루틴이 실제로 코드를 실행하는 순간에만 스레드가 필요하고, 중단되어 있는 순간에는 필요하지 않다.
- 수천 개의 코루틴이 스레드 하나도 쓰지 않고 동시에 중단되어 있을 수 있다. 실제로 실행 중인 코루틴만 각자 스레드가 필요하다.
그래서 코루틴은 스레드에 비해 비용이 저렴하다. OS 스레드는 바쁘게 일하고
있든 유휴 상태든 상관없이, 처음부터 자신만의 콜 스택을 미리 확보해둔다
(JVM에서는 보통 1MB 정도). 반면 중단된 코루틴은 그저 Continuation
객체 하나일 뿐이며, 보통 수십 바이트 정도의 크기로 힙 위에 머물러 있다가
무언가가 다시 시작시켜줄 때까지 기다린다.
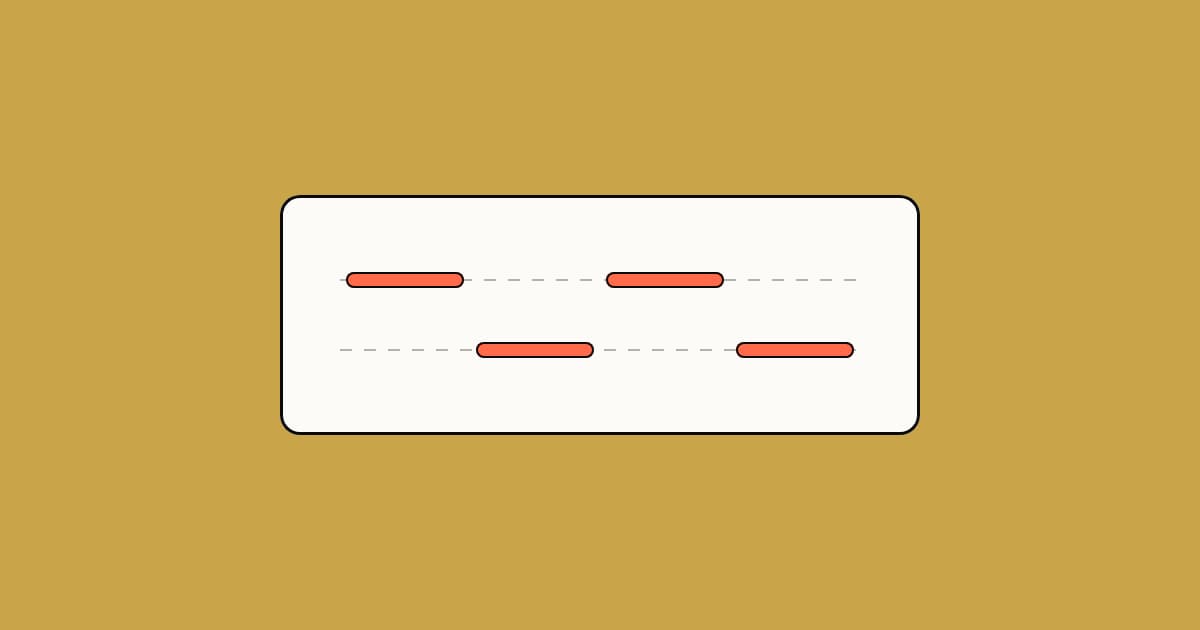
Solid = holding the dispatcher thread. Faint = waiting its turn. Hollow = suspended, holding no thread at all. However many coroutines are running, only one is ever actually on the thread at once.
이것은 그저 추상적인 스케줄링 퍼즐이 아니다. 바로 이 단일 스레드 인터리빙이 평범한 길게 누르기 버튼 애니메이션을 동작하게 만드는 원리다:
val scope = rememberCoroutineScope()
val scale = remember { Animatable(1f) }

Modifier.pointerInput(Unit) {
    detectTapGestures(onPress = {
        scope.launch { scale.animateTo(1.2f) } // queued, doesn't run inline
        tryAwaitRelease()                      // suspends here, thread freed
        scope.launch { scale.animateTo(1f) }   // retargets the same Animatable
    })
}scope.launch는 커지는 애니메이션을 즉시 그 자리에서 실행하지 않는다.
대신 rememberCoroutineScope()의 Dispatcher(UI 스레드) 위에 새로운
Job을 예약해두고 곧바로 리턴한다. 그다음 tryAwaitRelease()가
중단되면서 스레드를 돌려주는데, 바로 이것이 커지는 애니메이션 자신의
중단 지점들(withFrameNanos, 다음 프레임을 기다리는 지점)이 차례를 받을
수 있게 해주는 이유다. 여기서 병렬로 실행되는 것은 아무것도 없다:
onPress 코루틴과 애니메이션 코루틴은 하나의 스레드 위에서 번갈아 차례를
주고받을 뿐이며, 위 데모와 똑같은 인터리빙을, "Launch coroutine"이라고
적힌 버튼 대신 화면 위의 손가락으로 겪고 있는 것일 뿐이다.
트리가 새는 곳: GlobalScope
class UserViewModel : ViewModel() {
    fun loadUser(id: String) {
        // Leak: this coroutine's parent is GlobalScope, which never gets
        // cancelled. It keeps running after the ViewModel is cleared,
        // holding a reference to it the whole time.
        GlobalScope.launch {
            val user = repository.fetchUser(id)
            _uiState.value = UiState.Loaded(user)
        }
    }
}
class UserViewModel : ViewModel() {
fun loadUser(id: String) {
// Fixed: viewModelScope's Job is a child of this ViewModel's
// lifecycle. onCleared() cancels it, which cancels this launch
// too, because it's actually in the tree.
viewModelScope.launch {
val user = repository.fetchUser(id)
_uiState.value = UiState.Loaded(user)
}
}
}GlobalScope는 그 무엇에도 묶여 있지 않은데, 바로 그것이 문제다. 부모가
없으므로 앱의 lifecycle 어디에서도 올라가서 이를 취소할 수 없다.
launch vs async: 아무도 제대로 알지 못하는 예외 타이밍
흔히 하는 말은 "launch는 즉시 던지고, async는 .await()를 호출할
때까지 기다린다"는 것이다. 이건 절반만 맞는 말이고, 빠진 절반이 바로
중요한 절반이다.
coroutineScope {
    launch {
        throw IllegalStateException("boom")
        // Propagates immediately: cancels this scope's other children
        // and rethrows once they've wound down.
    }
}
coroutineScope {
val deferred = async {
throw IllegalStateException("boom")
// Still propagates immediately through the parent job, same as
// launch above, because this async has a structured parent.
// await() is never even reached.
}
deferred.await()
}val deferred = GlobalScope.async {
throw IllegalStateException("boom")
// Only deferred here: this async has no structured parent to
// propagate to, so the exception just sits in the Deferred until
// something calls await() on it. Forget to call await(), and the
// exception disappears silently.
}규칙은 "launch 대 async"가 아니다. 진짜 규칙은 "이 코루틴이 트리
안에 부모를 가지고 있는가"이다. scope 안에 네스트되어 있다면 둘 다
똑같은 방식으로 전파된다: 즉시, 트리를 통해서. ".await()를 기다리는"
동작이 나타나는 경우는 오직 벌거벗은, 부모 없는 async뿐이며, 이는
위에서 본 GlobalScope 누수와 근본 원인이 동일하다: 부모가 없으면
아무것도 자동으로 전파되지 않는다.
근본 원리
이것이 바로 structured concurrency다: 모든 코루틴은 부모를 가지고
있으며, 자신의 생명주기를 정의하는 CoroutineScope에 속해 있다. Job은
단순한 핸들이 아니라, 코루틴이 그 트리 안에서 차지하는 위치 그 자체다.
취소는 트리를 따라 아래로 흐르고(부모를 취소하면 모든 자손이 취소된다),
실패는 트리를 따라 위로 흐른다(처리되지 않은 자식의 실패는 형제들을
취소시키고 부모에게 전파된다), 누군가 일부러 그 연결 중 하나를
끊어버리지 않는 한은 그렇다.
다른 곳에서도: 같은 근본 원리, 다른 프레임워크
- Swift의 structured concurrency:
TaskGroup안에서 생성된Task는 같은 방식으로 그 그룹의 자식이 된다. 부모Task를 취소하면 트리 전체에서Task.isCancelled가 true로 바뀌고, 그룹의 자식 중 하나가 예외를 던지면 나머지 자식들도 취소되는데, 위에서 본 것과 같은 전파 형태다. - Python의 Trio: "structured concurrency"라는 용어가 말 그대로
처음 만들어진 곳이다. Trio의 가
바로 scope다. nursery 없이는 task를 생성할 수 없고, nursery 블록은
자신이 연 모든 자식이 끝날 때까지 종료되지 않는데,
CoroutineScope와 같은 생명주기 경계 개념이다. - Python의
asyncio.TaskGroup(3.11+): Trio의 구조화된 모델을asyncio에 들여오기 위해 특별히 추가되었다. 그 전까지는 부모 없이asyncio.create_task()를 그냥 실행할 수 있었는데, 이는 위에서 본GlobalScope문제와 정확히 같다. - 이와 대조적으로 Go는 언어 차원에 structured concurrency를 위한
primitive가 없다. 벌거벗은
go func() {}()는 기본적으로GlobalScope.launch와 같다: 아무것도 이를 추적하지 않고, 아무것도 자동으로 취소하지 않는다.errgroup과context.Context는 트리가 내장되어 있지 않은 것을 뒤늦게 고치기 위해 덧붙여진 해결책으로 존재한다. - Node/TypeScript도 Go와 같은 처지다.
Promise에는 내장된 취소 기능이 전혀 없고,Promise.all은 다른 Promise들을 취소하지 않은 채 하나라도 reject되는 순간 바로 reject된다. 나머지는 아무도 지켜보지 않는 채로 계속 실행된다.AbortController/AbortSignal이Job에 가장 가까운 대응물이지만, 이는 수동적이다: signal을 만들어서 이를 확인하기로 선택한 대상에게 명시적으로 전달해줘야 한다. 아무것도 이를 자동으로 전파하거나 트리로 만들어주지 않는다.
Job의 종류
Job은 하나로 고정된 동작이 아니라, 트리가 실패를 전파하는 방식이나
수동 제어를 노출하는 방식에 대한 규칙 하나씩을 각각 바꾸는 변형들을
가진 인터페이스다. 트리의 구조(부모/자식 관계, 취소가 아래로 흐르는 것)는
이 모든 변형에서 동일하게 유지된다.
| Job 종류 | 생성 방법 | 실패 시 형제도 취소되는가? | 일반적인 용도 |
|---|---|---|---|
Job | launch/async의 기본값, coroutineScope { } | 그렇다 | 기본 structured concurrency: "한 부분이 실패하면 전체 작업을 멈춘다" |
SupervisorJob | SupervisorJob(), supervisorScope { }, viewModelScope | 아니다, 직계 자식에게만 적용 | 하나의 scope 아래에서 독립적으로 수행되는 병렬 작업: "한 부분이 실패해도 나머지는 계속 진행되어야 한다" |
CompletableJob | Job()/SupervisorJob() 팩토리 함수가 실제로 반환하는 것 | 감싸고 있는 base와 동일 | complete()/completeExceptionally()로 job을 수동으로 완료 표시하는 것, supervisor 여부와는 별개의 축 |
사람들이 자주 걸려 넘어지는 디테일은 "직계 자식에게만 적용"이라는
열이다: SupervisorJob의 보호는 바로 아래 직계 자식을 넘어서까지는
미치지 않는다. 그 자식 중 하나가 launch로 자신의 손자 코루틴을
만든다면, 손자의 실패는 여전히 평범하게 그 직계 부모(즉 그 직계
자식)에게까지 전파되어 그 자식 자신의 하위 가지를 취소시킨다.
supervisor는 오직 실패가 자기 자신을 넘어서 더 위로 올라가는 것만
막아준다.
엣지 케이스
취소는 협력적이며, 즉각적이지 않다
job.cancel()을 호출해도 스레드를 강제로 죽이는 것처럼 문장 중간에서
코드를 끊어버리지는 않는다. 이 호출은 중단 지점에서 확인되는 플래그를
하나 뒤집을 뿐이다. 그래서 delay()도, yield()도, 그 안에 중단되는
호출이 전혀 없는 busy loop는 "취소된" 뒤에도 그냥 계속 실행된다:
val job = launch {
    while (true) {
        // No suspension point in this loop: isActive never gets checked
        // automatically, so cancel() has nothing to interrupt.
        computeSomething()
    }
}
job.cancel() // the loop above keeps running forever
해결책은 루프 안에서 isActive를 확인하거나 ensureActive()를
호출하는 것이다. 그렇게 하면 취소가 실제로 적용될 지점이 생긴다.
CancellationException은 실패로 전파되지 않는다
val job = launch {
    try {
        doWork()
    } catch (e: Exception) {
        log.error("doWork failed", e) // also catches CancellationException
    }
}
job.cancel()
// doWork() keeps running past the catch block: cancel() threw
// CancellationException to unwind the coroutine, but this catch
// swallowed it like any other Exception, so nothing actually stops.
코루틴을 취소하는 것은 단순히 플래그를 뒤집는 것으로 끝나지 않는다.
코루틴이 현재 머물러 있는 중단 지점에서 CancellationException을
던지는데, 이는 실제 실패가 콜 스택을 풀어낼 때 쓰는 것과 동일한
메커니즘이다.
차이는 그 예외가 Job에 도달한 뒤에 벌어지는 일에 있다:
- 코루틴 내부 메커니즘은
CancellationException을 특별히 확인해서, 이를 실패가 아니라 "이 가지는 하라는 대로 끝났다"는 의미로 처리한다. - 이는
CoroutineExceptionHandler에 절대 보고되지 않는다. - 위
launch/async절에서 본 실패들과 달리, 형제를 취소시키거나 오류로서 부모에게 전파되지도 않는다.
그래서 코루틴 안에서 Exception을 폭넓게 catch하는 것은 단순히
스타일이 나쁜 게 아니라 실제 버그다. CancellationException은
Exception의 서브타입이기 때문에, 포괄적인 catch는 다른 모든 것과
함께 이를 삼켜버리고, 분명히 취소되었어야 할 코루틴이 그 뒤에도 계속
실행된다.
해결책은 더 좁은 타입을 catch하거나, 잡힌 예외가
CancellationException일 때 다시 던지는 것이다:
val job = launch {
    try {
        doWork()
    } catch (e: CancellationException) {
        throw e // let cancellation keep propagating
    } catch (e: Exception) {
        log.error("doWork failed", e)
    }
}
job.cancel()
// The CancellationException branch rethrows immediately, so cancellation
// still unwinds the coroutine. A real failure from doWork() still falls
// through to the logging branch below it, same as before.withContext는 가지를 추가하지 않는다
withContext는 launch/async와 마찬가지로 중단 람다를 받기 때문에,
이것 역시 새로운 가지를 띄우는 것으로 읽고 싶어진다. 하지만 그렇지 않다.
suspend fun loadUser(id: String): User {
    val user = withContext(Dispatchers.IO) {
        repository.fetchUserBlocking(id) // runs on IO, caller suspends here
    }
    // Reached only once the block above finishes. Same coroutine, same
    // Job as loadUser itself, just back on the original dispatcher.
    log.info("loaded $user")
    return user
}withContext는 Job도 Deferred도 돌려주지 않는다. 붙잡아 둘 것이
아무것도 없다. 호출한 코루틴을 중단시키고, 블록이 실행되는 동안만
dispatcher(또는 넘긴 다른 context 요소)를 전환한 뒤, 그 블록이 끝나면
결과와 함께 재개한다. 호출 지점과 동시에 실행되는 것은 아무것도 없고,
추적해야 할 두 번째 가지도 없다. 그동안 내내 트리 안의 같은 노드일
뿐이다. withContext 블록 안에 코루틴이 머무는 동안 부모를 취소하면,
다른 중단 지점과 마찬가지로 그 블록도 함께 취소된다. 애초에 독립된
노드가 아니었기 때문이다.
runBlocking은 다리일 뿐, 트리의 일원이 아니다
위의 withContext처럼, runBlocking도 기존 트리에 가지를 추가하지
않는데, 이유는 정반대다. 애초에 평소의 그림에 들어맞을 생각이 없는
것이다. 이것은 중단되지 않는 코드(main(), JVM 테스트, 그
자체로는 코루틴이 아닌 콜백)에서 중단 가능한 코드를 호출하기 위해
존재하며, 이를 위해 자신의 코루틴 본문이 끝날 때까지 호출한 스레드를
블로킹한다. 프로덕션 Android 코드 깊은 곳 어딘가에 runBlocking을
끼워 넣으면, 이 시스템 전체가 존재하는 이유인 바로 그 스레드 블로킹을
다시 끌고 들어오는 셈이다.
실제 사용 사례
viewModelScope/lifecycleScope:ViewModel이나LifecycleOwner의 생명주기에 묶여 있는 Android의 미리 만들어진 scope로,Job을 직접 관리하지 않아도 트리를 공짜로 얻을 수 있다.- Flow 수집:
flow.collect { }는 자신을 호출한 scope 안에서 실행되므로, 그 scope를 취소하면 수집도 함께 멈춘다. 같은 트리다. WorkManager의CoroutineWorker: 라이브러리가 작업 요청마다 scope를 하나씩 소유하고, 작업이 취소되거나 타임아웃되면 이를 취소하므로doWork()는 자신만의Job을 관리할 필요가 없다.
코루틴은 절대 홀로 떠다니지 않는다. 코루틴은 언제나 트리 안의 한 노드이며, 여러분이 실제로 관리하는 것은 코루틴 자신이 아니라 바로 그 트리다.