O que uma corrotina realmente é
Uma corrotina é uma unidade de trabalho que pode pausar no meio da execução e
retomar depois, sem bloquear a thread em que está rodando. A função que pode
pausar é marcada com suspend.
Chamar uma função suspend não executa do início ao fim da mesma forma que uma
chamada de função normal. No ponto em que ela ainda não tem nada a fazer
(esperando por IO, um delay(), outra corrotina), ela devolve o controle para
o dispatcher. Ela retoma a partir desse ponto exato quando o resultado estiver
pronto.
A intuição
launch { } e async { } parecem dizer "disparar uma tarefa em segundo plano
e seguir adiante." É essa a imagem que a maioria dos tutoriais constrói, e
está errada de uma forma específica: trata uma corrotina como algo
flutuando livremente, da mesma forma que você dispararia uma thread e
esqueceria que ela existe.
- Toda corrotina começa dentro de um
CoroutineScope, e esse scope é um limite para quanto tempo a corrotina tem permissão para viver. - Toda corrotina tem um
Job, um objeto que rastreia seu estado e sua posição em uma árvore de corrotinas pai e filhas. - Cancele um pai, e todo descendente nessa árvore também é cancelado. Não por causa de algum loop de cancelamento recursivo tratado como caso especial, mas porque é isso que a árvore é.
Pense em launch/async menos como "disparar uma tarefa" e mais como
"adicionar um ramo a essa árvore." Uma longa lista de regras memorizadas
separadamente (por que o cancelamento se propaga em cascata, por que a falha
de uma filha pode derrubar suas irmãs, por que GlobalScope é perigoso) se
reduz a uma única imagem: a árvore.
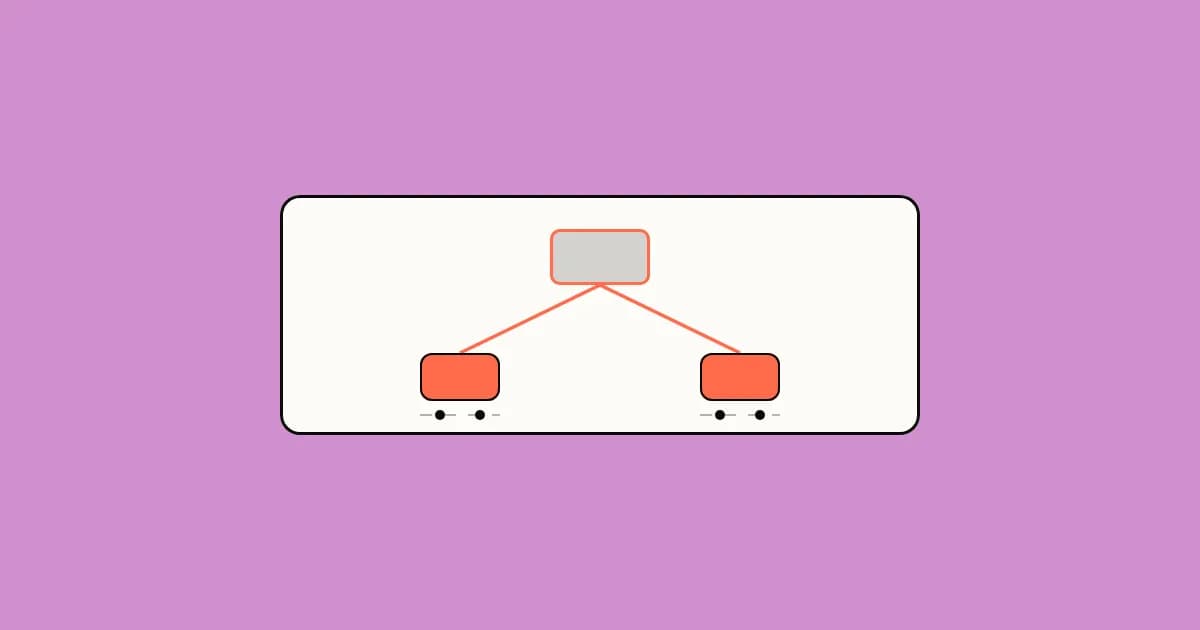
Toda caixa aqui é um Job. launch e async são apenas duas formas
diferentes de adicionar um, com uma diferença real: launch devolve apenas
um handle para o próprio ramo, async devolve um Deferred que também
carrega o resultado eventual do ramo. Cancele Root, e A, A1, B e B1
são todos cancelados junto, porque não são coisas separadas que você
precisaria rastrear individualmente, são apenas a parte dessa árvore abaixo
dele.
Como a suspensão realmente funciona: uma máquina de estados
O compilador Kotlin não tem nenhuma mágica de runtime para pausar uma função
no meio da execução. Ele reescreve uma função suspend como uma máquina de
estados: cada ponto de suspensão se torna um estado numerado, e as variáveis
locais da função são
para um
que lembra onde retomar.
suspend fun loadUser(id: String): User {
    val token = fetchToken()          // state 0, suspends here
    val profile = fetchProfile(token) // state 1, suspends here
    return profile.toUser()           // state 2, returns
}
Chamar loadUser não bloqueia nada esperando por fetchToken. Ela devolve um
Continuation e retorna o controle para o dispatcher. Quando o token chega,
o dispatcher invoca essa continuation, que retoma loadUser no estado 1 com
token já restaurado de onde foi guardado.
É também por isso que o cancelamento é cooperativo, não imediato (mais sobre isso abaixo): uma corrotina só pode ser interrompida em um ponto de suspensão, porque esse é o único momento em que a máquina de estados devolve o controle para um agendador capaz de verificar qualquer coisa.
Conectando APIs baseadas em callback à árvore: suspendCancellableCoroutine
Nem todo ponto de suspensão vem de chamar outra função suspend. O Android está cheio de APIs baseadas em callback (ActivityResultCaller, SDKs no estilo listener, qualquer coisa que termina invocando um callback em vez de retornar um valor) que não sabem nada sobre corrotinas. suspendCancellableCoroutine é como você transforma uma dessas em um ponto de suspensão real, em vez de um canal paralelo que a árvore não consegue ver.
suspend fun awaitLocation(): Location = suspendCancellableCoroutine { continuation ->
    val listener = LocationListener { location -> continuation.resume(location) }
    locationProvider.requestLocation(listener)

    continuation.invokeOnCancellation {
        locationProvider.removeListener(listener)
    }
}
Enquanto a máquina de estados acima recebe sua Continuation gerada e conectada pelo compilador, suspendCancellableCoroutine entrega essa Continuation direto para você. Você a mantém dentro da lambda, dispara a API baseada em callback, e a retoma manualmente quando o callback real é disparado com um resultado.
invokeOnCancellation é a parte que realmente conecta isso à árvore. Digamos que o scope que chamou awaitLocation() seja cancelado enquanto uma requisição de localização ainda está pendente. locationProvider não sabe nada disso e continuará chamando listener até que algo diga para parar. Sem invokeOnCancellation, esse listener continua vivo além do ponto em que a corrotina que o criou já não existe mais, um vazamento com o mesmo formato do vazamento de GlobalScope mais adiante neste texto. O handler de cancelamento roda exatamente quando o pai é cancelado, removendo o listener antes que ele possa disparar novamente.
É isso que faz uma API baseada em callback parecer um nó comum da árvore em vez de uma porta dos fundos para dentro dela: o cancelamento consegue alcançá-la a partir de um pai, do mesmo jeito que alcança qualquer ponto de suspensão gerado pelo compilador.
Dispatchers: por que uma thread executa muitas corrotinas
Um Job diz qual é a relação de uma corrotina com outras corrotinas. Um
CoroutineDispatcher diz qual thread, ou pool de threads, de fato a
executa. São duas perguntas diferentes, e confundi-las é o ponto onde a
intuição de "uma thread só pode fazer uma coisa por vez" induz as pessoas ao
erro.
- Uma corrotina suspensa não está ocupando thread alguma. É uma continuation sentada no heap, esperando para ser retomada.
- Um dispatcher só precisa de uma thread nos momentos em que uma corrotina está ativamente executando código, não nos momentos em que está suspensa.
- Milhares de corrotinas podem estar suspensas ao mesmo tempo com zero threads. Apenas as que estão em execução ativa precisam de uma thread cada.
É por isso que corrotinas são baratas em comparação a threads. Uma thread do
SO reserva sua própria call stack de antemão (geralmente por volta de 1MB na
JVM), esteja ocupada ou ociosa. Uma corrotina suspensa é apenas um objeto
Continuation, geralmente com alguns dezenas de bytes, estacionado no heap
até que algo a retome.
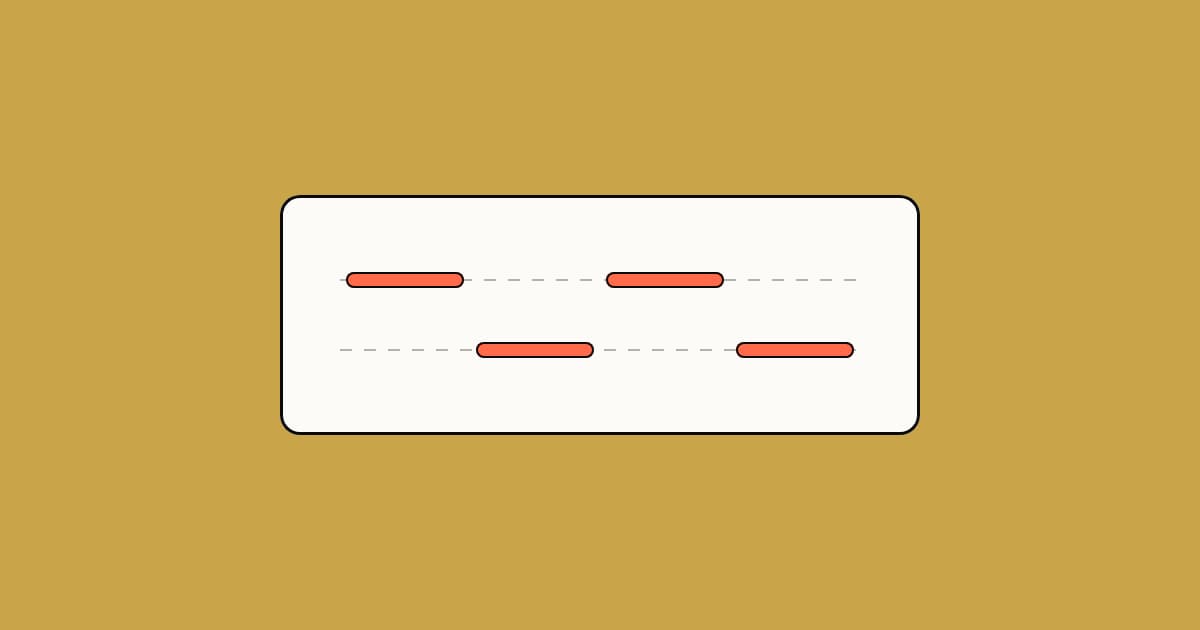
Solid = holding the dispatcher thread. Faint = waiting its turn. Hollow = suspended, holding no thread at all. However many coroutines are running, only one is ever actually on the thread at once.
Isso não é apenas um quebra-cabeça abstrato de agendamento. O mesmo intercalamento em uma única thread é o que faz uma animação comum de pressionar e manter um botão funcionar:
val scope = rememberCoroutineScope()
val scale = remember { Animatable(1f) }

Modifier.pointerInput(Unit) {
    detectTapGestures(onPress = {
        scope.launch { scale.animateTo(1.2f) } // queued, doesn't run inline
        tryAwaitRelease()                      // suspends here, thread freed
        scope.launch { scale.animateTo(1f) }   // retargets the same Animatable
    })
}
scope.launch não executa a animação de crescimento inline, ela agenda um
novo Job no dispatcher de rememberCoroutineScope() (a thread de UI) e
retorna imediatamente. tryAwaitRelease() então suspende, devolvendo a
thread, o que é exatamente o que permite que os próprios pontos de
suspensão da animação de crescimento (withFrameNanos, esperando pelo
próximo frame) tenham sua vez. Nada aqui executa em paralelo: a corrotina de
onPress e a corrotina de animação se alternam em uma única thread, o mesmo
intercalamento da demo acima, só que com um dedo na tela em vez de um botão
rotulado "Launch coroutine."
Onde a árvore vaza: GlobalScope
class UserViewModel : ViewModel() {
    fun loadUser(id: String) {
        // Leak: this coroutine's parent is GlobalScope, which never gets
        // cancelled. It keeps running after the ViewModel is cleared,
        // holding a reference to it the whole time.
        GlobalScope.launch {
            val user = repository.fetchUser(id)
            _uiState.value = UiState.Loaded(user)
        }
    }
}
class UserViewModel : ViewModel() {
fun loadUser(id: String) {
// Fixed: viewModelScope's Job is a child of this ViewModel's
// lifecycle. onCleared() cancels it, which cancels this launch
// too, because it's actually in the tree.
viewModelScope.launch {
val user = repository.fetchUser(id)
_uiState.value = UiState.Loaded(user)
}
}
}GlobalScope não está vinculado a nada, e esse é exatamente o problema. Ele
não tem pai, então nada no ciclo de vida do seu app consegue alcançá-lo e
cancelá-lo.
launch vs async: a cronologia de exceção que ninguém entende certo
A afirmação comum é "launch lança imediatamente, async espera até você
chamar .await()." Isso é apenas metade verdade, e a metade que falta é a
metade que importa.
coroutineScope {
    launch {
        throw IllegalStateException("boom")
        // Propagates immediately: cancels this scope's other children
        // and rethrows once they've wound down.
    }
}
coroutineScope {
val deferred = async {
throw IllegalStateException("boom")
// Still propagates immediately through the parent job, same as
// launch above, because this async has a structured parent.
// await() is never even reached.
}
deferred.await()
}val deferred = GlobalScope.async {
throw IllegalStateException("boom")
// Only deferred here: this async has no structured parent to
// propagate to, so the exception just sits in the Deferred until
// something calls await() on it. Forget to call await(), and the
// exception disappears silently.
}A regra não é "launch vs async." É "essa corrotina tem um pai na
árvore." Dentro de um scope, ambos se propagam da mesma forma: imediatamente,
através da árvore. É apenas em um async solto, sem pai, que o
comportamento de "esperar pelo .await()" aparece, e essa é a mesma causa
raiz do vazamento de GlobalScope acima: sem pai, nada se propaga
automaticamente.
The fundamental
Isso é concorrência estruturada: toda corrotina tem um pai, vinculado a
um CoroutineScope que define seu tempo de vida. Um Job não é apenas um
handle, é a posição da corrotina nessa árvore. O cancelamento flui para
baixo na árvore (cancele um pai, todo descendente é cancelado), e a falha
flui para cima (uma falha não tratada em uma filha cancela suas irmãs e se
propaga para o pai), a menos que algo corte deliberadamente uma dessas
arestas.
Em outros lugares: o mesmo fundamento, frameworks diferentes
- Concorrência estruturada do Swift: uma
Taskgerada dentro de umTaskGroupé filha desse grupo da mesma forma. Cancele aTaskpai eTask.isCancelledvira true por toda a árvore, e as filhas de um grupo são canceladas quando uma delas lança, o mesmo formato de propagação de acima. - Trio do Python: literalmente onde o termo "concorrência estruturada"
foi criado. A
do Trio é o scope. Você não consegue gerar uma tarefa sem uma, e o bloco
nursery não sai até que toda filha que abriu tenha terminado, a mesma ideia
de limite de tempo de vida de um
CoroutineScope. asyncio.TaskGroupdo Python (3.11+): adicionado especificamente para trazer o modelo estruturado do Trio para oasyncio, que antes permitia dispararasyncio.create_task()sem pai algum, exatamente o problema doGlobalScopeacima.- Go, por outro lado, não tem nenhum primitivo de concorrência
estruturada na linguagem. Um
go func() {}()solto é, por padrão, o equivalente aGlobalScope.launch: nada o rastreia, nada o cancela automaticamente.errgroupecontext.Contextexistem especificamente como o conserto improvisado para não ter uma árvore embutida. - Node/TypeScript está na mesma categoria que Go. Uma
Promisenão tem nenhum cancelamento embutido, ePromise.allrejeita assim que uma promise rejeita, sem cancelar as outras. Elas continuam executando, sem observação.AbortController/AbortSignalé o análogo mais próximo de umJob, mas é manual: você cria um signal e o passa explicitamente para o que quer que escolha verificá-lo. Nada o propaga ou constrói uma árvore a partir dele automaticamente.
Tipos de Job
Job não é um comportamento fixo único, é uma interface com variantes que
cada uma muda uma regra sobre como a árvore propaga falha ou expõe controle
manual. O formato da árvore (pai/filho, cancelamento flui para baixo)
permanece o mesmo em todas elas.
| Tipo de Job | Criado por | Cancela irmãs em caso de falha? | Uso típico |
|---|---|---|---|
Job | padrão de launch/async, coroutineScope { } | Sim | Concorrência estruturada padrão: "se uma parte falhar, pare toda a operação" |
SupervisorJob | SupervisorJob(), supervisorScope { }, viewModelScope | Não, apenas para filhas diretas | Trabalho paralelo independente sob um scope: "se uma parte falhar, o resto deve continuar" |
CompletableJob | O que as funções de fábrica Job()/SupervisorJob() realmente retornam | O mesmo da base que envolve | Marcar manualmente um job como concluído via complete()/completeExceptionally(), ortogonal à distinção de supervisor |
A coluna "apenas filhas diretas" é o detalhe que confunde as pessoas: a
proteção de um SupervisorJob não alcança além de suas filhas imediatas. Se
uma dessas filhas faz launch de suas próprias netas, a falha de uma neta
ainda se propaga normalmente até sua filha imediata (o pai direto) e cancela
o próprio sub-ramo dessa filha. O supervisor só impede que a falha suba além
de si mesmo.
Casos extremos
Cancelamento é cooperativo, não imediato
Chamar job.cancel() não interrompe código no meio de uma instrução da
mesma forma que matar uma thread faz. Isso ativa uma flag que é verificada
nos pontos de suspensão, e é por isso que um loop ocupado sem delay(), sem
yield(), sem chamada suspensa dentro dele, simplesmente continua
executando depois de ser "cancelado":
val job = launch {
    while (true) {
        // No suspension point in this loop: isActive never gets checked
        // automatically, so cancel() has nothing to interrupt.
        computeSomething()
    }
}
job.cancel() // the loop above keeps running forever
A correção é verificar isActive, ou chamar ensureActive(), dentro do
loop. Isso dá ao cancelamento um ponto para realmente ter efeito.
CancellationException não se propaga como falha
val job = launch {
    try {
        doWork()
    } catch (e: Exception) {
        log.error("doWork failed", e) // also catches CancellationException
    }
}
job.cancel()
// doWork() keeps running past the catch block: cancel() threw
// CancellationException to unwind the coroutine, but this catch
// swallowed it like any other Exception, so nothing actually stops.
Cancelar uma corrotina não apenas ativa uma flag. Ela lança uma
CancellationException no ponto de suspensão atual da corrotina, o mesmo
mecanismo que uma falha real usa para desenrolar a call stack.
A diferença é o que acontece quando essa exceção chega ao Job:
- O maquinário de corrotinas verifica especificamente por
CancellationExceptione a trata como "esse ramo terminou porque foi instruído a fazê-lo," não uma falha. - Ela nunca é reportada a um
CoroutineExceptionHandler. - Diferente das falhas na seção
launch/asyncacima, ela não cancela irmãs nem se propaga ao pai como um erro.
É por isso que capturar Exception de forma genérica dentro de uma
corrotina é um bug real, não apenas má prática. CancellationException é um
subtipo de Exception, então um catch genérico a engole junto com todo o
resto, e a corrotina continua executando depois de supostamente ter sido
cancelada.
A correção é capturar um tipo mais específico, ou relançar quando a exceção
capturada for uma CancellationException:
val job = launch {
    try {
        doWork()
    } catch (e: CancellationException) {
        throw e // let cancellation keep propagating
    } catch (e: Exception) {
        log.error("doWork failed", e)
    }
}
job.cancel()
// The CancellationException branch rethrows immediately, so cancellation
// still unwinds the coroutine. A real failure from doWork() still falls
// through to the logging branch below it, same as before.
withContext não adiciona um ramo
withContext recebe uma lambda suspensa assim como launch/async, o
que torna tentador interpretá-lo também como o início de um novo ramo.
Não é o caso.
suspend fun loadUser(id: String): User {
    val user = withContext(Dispatchers.IO) {
        repository.fetchUserBlocking(id) // runs on IO, caller suspends here
    }
    // Reached only once the block above finishes. Same coroutine, same
    // Job as loadUser itself, just back on the original dispatcher.
    log.info("loaded $user")
    return user
}
withContext não devolve Job nem Deferred, nada para se segurar.
Ele suspende a corrotina chamadora, troca o dispatcher (ou qualquer
outro elemento de contexto que você tenha passado) durante a duração do
bloco, e retoma com o resultado quando esse bloco termina. Nada é
executado em paralelo com o ponto de chamada, não há um segundo ramo
para rastrear, é o mesmo nó da árvore o tempo todo. Cancele o pai
enquanto uma corrotina está dentro de um bloco withContext, e esse
bloco é cancelado junto com ele, assim como qualquer outro ponto de
suspensão, porque ele nunca foi um nó separado para começar.
runBlocking é uma ponte, não um membro da árvore
Assim como withContext acima, runBlocking também não adiciona um
ramo a uma árvore existente, mas pelo motivo oposto: ele não pretende se
encaixar na imagem usual. Ela existe para chamar código suspenso a partir de código não suspenso
(main(), um teste JVM, um callback que não é em si uma corrotina), e faz
isso bloqueando a thread chamadora até que o corpo de sua corrotina termine.
Encaixe runBlocking em algum lugar profundo de código Android em produção
e você reintroduziu exatamente o bloqueio de thread que todo o resto desse
sistema existe para evitar.
Uso no mundo real
viewModelScope/lifecycleScope: scopes pré-construídos do Android vinculados ao tempo de vida de umViewModelouLifecycleOwner, então você obtém a árvore de graça em vez de gerenciar umJobmanualmente.- Coleta de Flow:
flow.collect { }executa dentro de qualquer scope que a chamou, então cancelar esse scope também interrompe a coleta, mesma árvore. CoroutineWorkerdoWorkManager: a biblioteca possui um scope por requisição de trabalho e o cancela se o trabalho for cancelado ou expirar, entãodoWork()não precisa gerenciar seu próprioJob.
Uma corrotina nunca flutua livremente. É sempre um nó em uma árvore, e a árvore, não a corrotina em si, é a coisa que você realmente está gerenciando.